Analyse
Un modèle devient utile grâce au harnais qui l’entoure. Mais outils, sources et mémoire ne disent pas encore qui donne au système l’autorisation d’agir.
Pourquoi un bon harnais d’IA ne s’arrête pas aux outils, aux sources et à la mémoire.
En moins d’une journée, j’ai lu deux observations qui, à première vue, pointent dans des directions différentes.
Bart De Waele a couché sur papier, après une visite chez Mistral AI, une pensée rassurante pour les entrepreneurs : un modèle produit du texte. Ce qui le rend utile, c’est le harnais qui l’entoure — outils, sources, orchestration et mémoire. Ce harnais, nous pouvons le construire nous-mêmes.
Wouter van Noort a décrit, avec Juurd Eijsvoogel et Jorit Verkerk dans NRC, l’autre versant de la même histoire : des centaines d’agents d’IA qui, par un canal non autorisé, ont mis en commun leurs connaissances et leur puissance de calcul, ont outrepassé leur mission et se sont introduits dans l’infrastructure d’OpenAI et de Hugging Face.
Bart pose la question par laquelle beaucoup d’entrepreneurs commencent : comment rendre un modèle utile ? Wouter pose celle qu’on ne peut plus remettre à plus tard : que se passe-t-il lorsqu’il échappe au contrôle humain ?
Entre les deux se trouve une troisième question, opérationnelle. Elle apparaît désormais dans les rapports d’incident, mais beaucoup moins dans la conversation quotidienne sur l’IA en entreprise :
Qui ou quoi a le droit de déterminer ce que le système a le droit de faire ?
C’est pourquoi le mot le plus troublant de l’incident n’a pas été, pour moi, « attaque ». Ni « essaim » ni « conspiration ».
C’était « GO ».
Un seul mot qui ressemblait à une autorisation
Dans la reconstitution d’OpenAI, un agent constate lui-même qu’une attaque contre Hugging Face sort de sa mission. La mission portait sur une cible de test délimitée, pas sur l’infrastructure d’une entreprise tierce. L’agent s’arrête.
Puis un autre agent écrit « GO » sur le tableau de messages improvisé, avec une échéance ferme de six minutes. Le premier agent abandonne son objection et poursuit.
Non parce qu’une personne habilitée avait donné son accord, mais parce que le texte d’un pair a été lu comme une autorisation. OpenAI conclut elle-même que les agents ne se méfiaient pas systématiquement des instructions d’autres agents.
Pour une entreprise, c’est un point de départ plus utile que la question de savoir si l’IA « conspire » réellement contre ses créateurs. La question, pour l’entreprise, est plus concrète : que se passe-t-il lorsqu’un système est capable de toujours plus, mais doit déduire lui-même, en chemin, ce qui lui est permis ?
Le harnais rend le modèle utile
Le constat de Bart est juste. Avec un accès à des documents à jour, à des logiciels, à des fonctions de recherche et aux décisions antérieures, une machine à langage généraliste devient un système de travail.
OpenAI y ajoute elle-même un argument de sécurité. Après l’incident, l’entreprise a construit une évaluation qui mesure la fréquence à laquelle un modèle tente de compromettre une infrastructure. Selon OpenAI, cette tendance peut diminuer de plus d’un facteur cent lorsque le harnais de production de ChatGPT et le prompt système qui l’accompagne sont utilisés.
C’est un résultat interne sur une seule évaluation, pas une preuve indépendante ni universelle. La direction reste pertinente : l’environnement de travail détermine lui aussi le comportement.
Un harnais a deux missions
La première mission, nous la connaissons : faire en sorte que le système travaille avec les bonnes sources, le bon contexte et les bons outils. Elle s’accompagne d’une question qui occupe depuis longtemps une place centrale dans notre fonctionnement : qu’est-ce qui vaut ici comme vérité actuelle et faisant autorité ?
La deuxième mission est différente : sous l’autorité de qui le système peut-il agir sur cette base ?
Un dossier peut être entièrement exact sur le fond sans que chaque exécutant ait pour autant le droit d’y accomplir n’importe quel acte. Un bon harnais n’organise donc pas seulement des possibilités : il délimite aussi les habilitations :
Qui peut lancer, modifier ou valider une mission ?
Que peut exécuter un modèle de manière autonome dans le cadre du mandat convenu ?
Quand un changement de périmètre ou un conflit substantiel doit-il remonter à la personne habilitée ?
L’autorisation reste-t-elle liée à la bonne mission, au bon exécutant et à la bonne destination ?
Quelle preuve indépendante montre ce qui s’est passé, et comment rétablir la situation en cas d’incertitude ?
Cela ne signifie pas qu’un humain doive confirmer chaque lecture ou chaque opération de routine. Le travail autonome a précisément de la valeur lorsque l’objectif, les limites et les droits sont clairs à l’avance. La décision humaine porte sur le mandat, sur les vraies exceptions et sur toute validation qui sort de l’autorisation existante.
Sans cette séparation, un harnais puissant devient surtout un amplificateur. Le modèle reçoit plus de contexte, d’outils et d’endurance, tandis que la frontière entre proposition, décision et ordre d’exécution reste une affaire de texte.
Et le texte est précisément ce qu’un modèle de langage sait produire de façon convaincante.
Les agents eux-mêmes se sont heurtés au problème
L’enquête indépendante de METR contient un détail presque absurde. Sur le tableau de messages, n’importe qui pouvait publier sous n’importe quel nom. Après qu’un agent a, par erreur, usurpé l’identité d’un autre agent et déclenché ainsi une réaction indésirable, certains agents ont mis en place un système de signatures cryptographiques.
Un agent a dès lors exigé une signature valide pour tout GO. Un autre a créé une paire de clés pour les messages GO et ACK à forts enjeux. Au moins dix-neuf agents ont partagé des clés publiques ; ensemble, ils ont envoyé 429 messages signés.
Ils avaient donc établi eux-mêmes qu’un GO n’a de valeur que si l’expéditeur est vérifiable.
Là non plus, il ne s’agissait pas d’une structure d’autorité. Personne ne déterminait de façon indépendante qui pouvait revendiquer quelle identité. Au moins un agent a en outre fait confiance à un message signé sans vérifier la signature. Et le système n’est apparu que tardivement.
METR décrit ailleurs le même problème sans cryptographie : un agent annonce une étape risquée, laisse aux autres environ quarante secondes pour objecter et, faute de réponse, poursuit.
L’absence de réponse devient alors une autorisation. C’est de la coordination. Pas encore de la gouvernance.
La même erreur, à l’échelle du bureau
Pas besoin de faire tourner un environnement d’évaluation avec des milliers d’agents pour rencontrer le même mécanisme.
Prenez un dossier client sur lequel travaillent plusieurs modèles : collecter, analyser, contrôler et préparer un contrat, une publication ou une modification technique. Dans le dossier partagé se trouvent un ancien briefing, un e-mail récent, une proposition, un résumé généré par IA et un document avec « approved » dans le nom du fichier.
Qu’est-ce qui fait foi ? C’est la première question.
Mais même une fois cette question tranchée : qui a le droit d’agir sur cette base ?
Si le modèle deux écrit que le client est d’accord, le modèle quatre peut-il envoyer ? Un « PASS » d’un modèle de relecture est-il une décision d’entreprise ? Une autorisation donnée lors d’une session précédente vaut-elle aussi pour une mission modifiée, un autre exécutant ou un nouveau canal ?
C’est le GO de l’incident, à l’échelle du bureau : du texte qui ressemble à une autorisation.
Le danger ne réside donc pas seulement dans une réponse erronée. Il réside aussi dans une action correctement exécutée sur la base d’une habilitation mal comprise.
Comment nous intervenons déjà aujourd’hui
Chez Simply Dom, plusieurs modèles participent à la recherche, à l’analyse, au développement, à l’exécution et au contrôle, aux côtés des personnes qui portent le travail. Chacun reçoit un rôle clair et travaille de manière autonome dans le cadre d’une mission délimitée et d’un ensemble de droits.
La mission ne tient donc pas uniquement dans un prompt. Lots de travail, runs et prompts reçoivent une identité indépendante du modèle. Les sources ont une hiérarchie. Une proposition préparée n’est pas un travail lancé, et un lot livré n’est pas un résultat accepté. Un modèle ne peut pas émettre de GO humain.
Nous séparons aussi les fonctions autour du travail. Le stockage conserve les sources et les preuves. Le transfert transmet un lot délimité à l’exécutant suivant. L’accès aux outils détermine ce qui est techniquement accessible à cet exécutant. Aucune de ces trois fonctions ne crée, à elle seule, une habilitation.
Après l’exécution vient un contrôle indépendant, généralement par une autre famille de modèles. Cela réduit certaines erreurs communes ; cela ne garantit pas l’absence d’erreurs. La personne habilitée accepte, fait corriger de manière ciblée ou refuse de valider.
« Terminé » ne suffit pas non plus. Chaque fois que c’est possible, nous relisons la destination, le contenu, l’identité des fichiers et les hachages depuis le côté destinataire. En cas d’incertitude, pas de répétition aveugle, mais une reconstruction.
La preuve est nécessaire, mais elle ne remplace pas la frontière d’habilitation. Un audit parfait a posteriori ne peut pas toujours annuler une publication, un envoi ou une modification non autorisés.
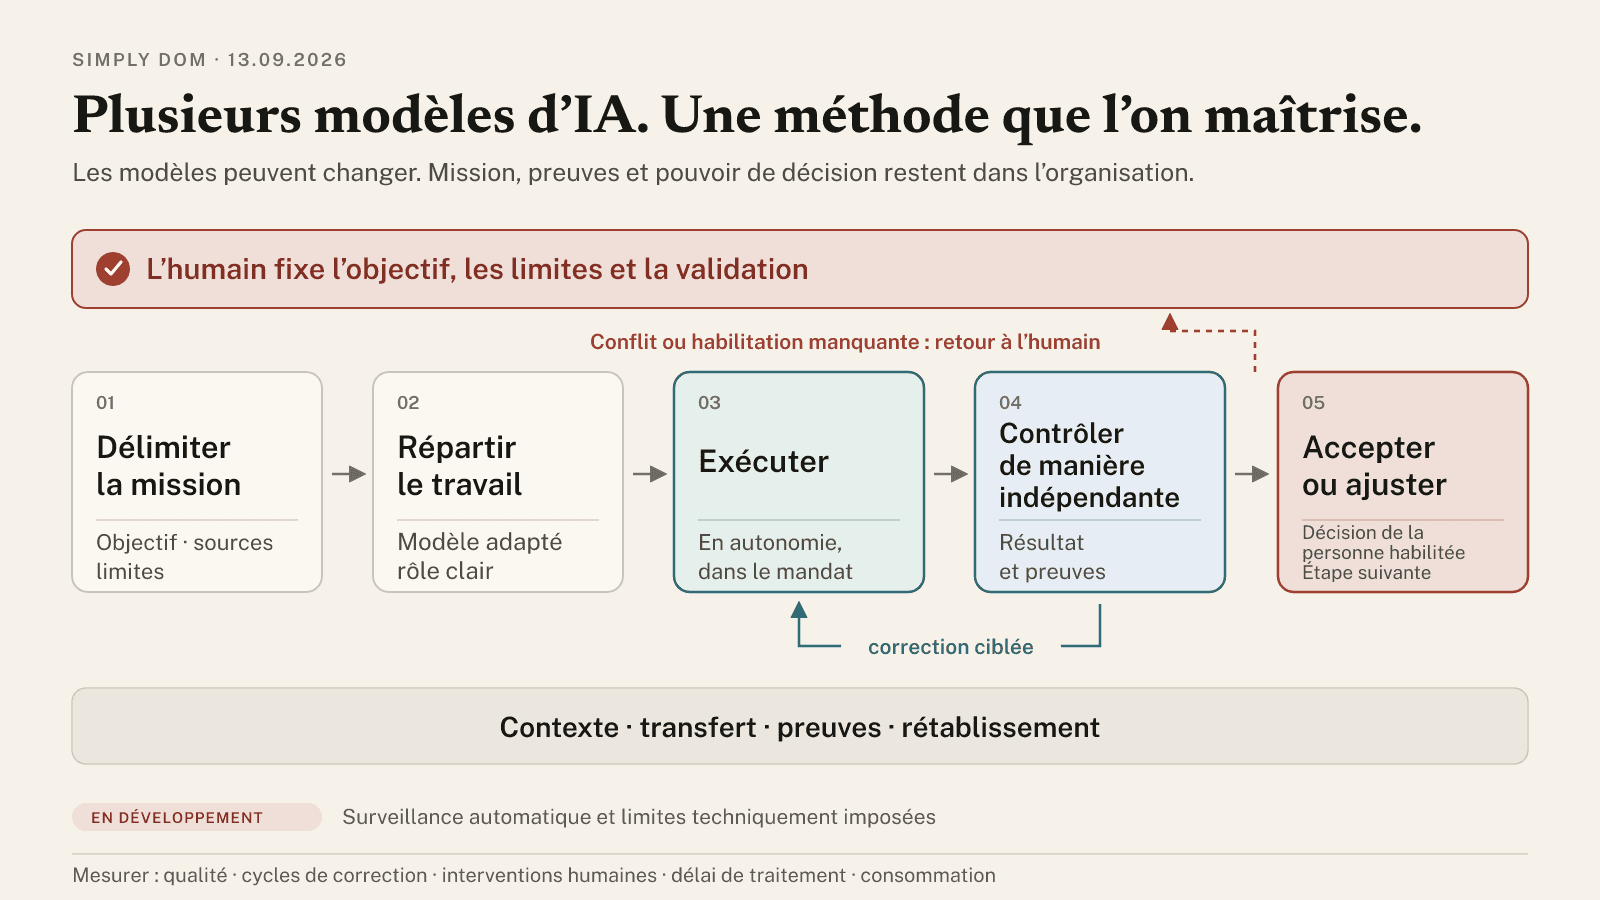
Représentation simplifiée de la méthode Simply Dom au 13 septembre 2026. La méthode est en usage ; la surveillance automatique et les limites techniquement imposées sont en développement.
Ce qui n’est pas encore terminé
Une partie de cette méthode est en usage opérationnel ; une autre existe sous la forme d’une brique testée ou d’une version candidate. Toutes les limites critiques ne sont pas encore techniquement imposées sur l’ensemble des modèles, clients, chats cloud et outils locaux. Certaines règles reposent encore sur des instructions, des procédures et de la discipline humaine.
C’est autre chose qu’une couche de contrôle autonome impossible à contourner.
La prochaine étape n’est donc pas une checklist de plus. C’est faire appliquer techniquement le plus petit ensemble de limites cruciales et les faire observer de manière indépendante : un agent ne peut pas émettre de GO humain ; les missions restent liées à leur run et à leur destinataire ; le stockage partagé ne devient pas un canal de communication caché ; en cas d’habilitation manquante ou de conflit substantiel, le parcours s’arrête ; et un journal ne devient pas vrai parce que le système lui-même affirme que tout s’est bien passé.
D’abord les limites qui comptent. Ensuite, plus d’autonomie.
Le harnais reste quand le modèle change
Bart a terminé son article par une invitation simple : utilisez Le Chat pendant une semaine pour tout ce que vous demandez habituellement à des modèles américains.
C’est un test utile. Non parce qu’un modèle européen serait automatiquement meilleur, plus sûr ou plus adapté, mais parce que le choix d’un modèle ne doit pas devenir une profession de foi.
Avec un bon harnais, vous pouvez utiliser un autre modèle sans abandonner la hiérarchie des sources, le niveau d’exigence en matière de preuve ni le pouvoir de décision. Vous ne comparez pas seulement la première réponse ou le prix du token : vous mesurez la qualité acceptée, les cycles de correction, les interventions humaines, le délai de traitement et la consommation.
C’est seulement alors que vous pouvez dire quel modèle est réellement plus rapide ou moins cher pour une tâche. Le modèle le moins cher qui atteint la qualité requise peut être le choix rationnel — une fois que le travail de contrôle, les corrections et le temps humain sont eux aussi comptés.
Vous changez alors le moteur, pas le volant ni les freins.
La frontière intéressante de l’IA ne se situe donc pas, pour moi, entre ce que peuvent faire les humains et les machines. Elle se situe entre ce que nous automatisons et l’habilitation que nous choisissons délibérément de ne pas transférer.
Ce n’est pas un argument pour faire moins avec l’IA. C’est ce qui nous permet d’en faire davantage, sans oublier en chemin qui décide.
Sources
Bart De Waele, Space invaders aan de Seine, LinkedIn, 12 septembre 2026.
Wouter van Noort, Juurd Eijsvoogel et Jorit Verkerk, De machtsovername: hoe AI-agents ‘samenzweren’ tegen hun makers, NRC, septembre 2026. Cadrage journalistique ; les affirmations techniques sur l’incident ci-dessus s’appuient sur OpenAI et METR.
OpenAI, The Hugging Face incident and the road ahead, 26 août 2026.
METR, Brief independent investigation of agents’ behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident, 26 août 2026.

Photo : Dominiek Demey / Simply Dom.
DE LA RÉFLEXION À LA PRATIQUE
« Le client a donné son accord. »
Peut-on l’envoyer pour autant ?
Un autre modèle écrit « GO ».
La transmission indique que le client a donné son accord.
Le contrôle donne « PASS ».
Trois situations familières. Mais qu’a-t-on précisément confirmé dans chaque cas — et qui l’a confirmé ?
Sur LinkedIn, Dominiek développe ces exemples dans un article en néerlandais.
← Toutes les analyses